WISSEN · AGENT-READY
Was sind Markdown-Twins und Content-Parität?
Ein Markdown-Twin ist ein Klartext-Zwilling einer HTML-Seite für KI-Agenten, Content-Parität ohne JavaScript bedeutet, dass alle relevanten Inhalte bereits im ausgelieferten HTML stehen. Beides sorgt dafür, dass eine Website von KI-Crawlern vollständig gelesen wird — auch von jenen, die kein JavaScript ausführen. Diese Wissens-Seiten von Studio Erdinc liefern ihren Inhalt vollständig ohne JavaScript; der Text, den Sie lesen, steht bereits roh im Quelltext.
- Was ist ein Markdown-Twin?
- Was heisst Content-Parität ohne JavaScript?
- Warum zählt das für KI-Crawler?
- Wie prüfen Sie Content-Parität?
- Wie Sie Twins und Parität umsetzen
- Was beweisen diese Seiten selbst?
- Häufige Fragen
- Quellen
Was ist ein Markdown-Twin?
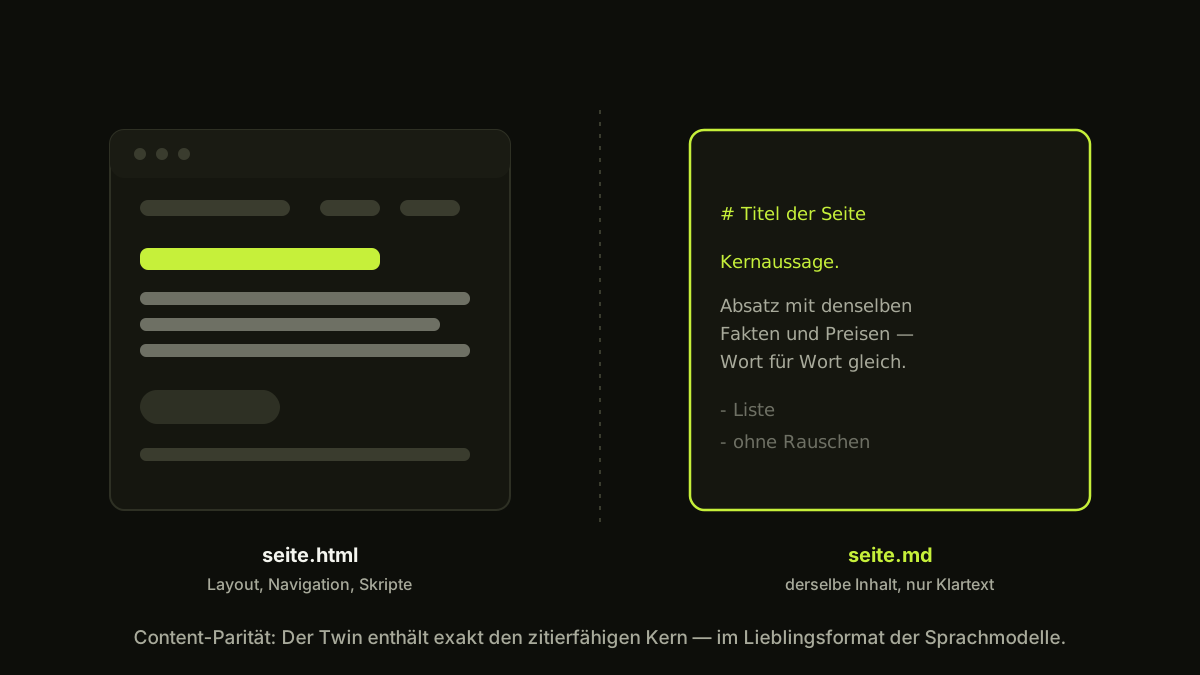
Ein Markdown-Twin ist eine saubere Markdown-Fassung einer HTML-Seite, die denselben Inhalt ohne Layout-, Navigations- und Skript-Rauschen enthält. Statt eine KI durch Menüs, Buttons, Grafik-Wrapper und CSS-Verschachtelung waten zu lassen, bekommt sie den nackten Kern: Überschriften, Fliesstext, Listen, Links — in dem Format, in dem Sprachmodelle ohnehin am liebsten arbeiten.
Der Twin wird auf zwei Wegen ausgeliefert. Erstens über Content Negotiation: Fragt ein Client mit dem Header Accept: text/markdown dieselbe URL an, liefert der Server statt HTML die Markdown-Variante. Zweitens als paralleler Zwilling mit .md-Endung — etwa seite.html und daneben seite.md mit identischem Inhalt. Beide Wege verfolgen dasselbe Ziel: Der zitierfähige Kern einer Seite existiert in einer Form, die eine Maschine ohne Umweg über Rendering und DOM-Extraktion sofort verwerten kann.
Ein Markdown-Twin ersetzt die HTML-Seite nicht — er begleitet sie. Menschen bekommen weiter das gestaltete Dokument, Maschinen bekommen die reduzierte Zwillingsfassung. Damit ist der Twin ein Baustein von Agent-Ready Webdesign: eine gezielte Massnahme, die Reibung zwischen Website und maschinellem Leser zu senken.
Was heisst Content-Parität ohne JavaScript?
Content-Parität ohne JavaScript bedeutet, dass alle relevanten Inhalte einer Seite bereits im ausgelieferten HTML stehen und nicht erst per JavaScript nachgeladen werden. Der Text, den ein Mensch nach dem Rendern im Browser sieht, muss deckungsgleich mit dem sein, was ein Crawler ohne JavaScript-Ausführung im rohen Quelltext vorfindet. Fehlt diese Deckung, klafft eine Lücke zwischen dem, was die Seite verspricht, und dem, was Maschinen tatsächlich lesen.
Der Grundsatz lautet: JavaScript darf verbessern, ist aber nie Voraussetzung für die Substanz. Animationen, Theme-Umschaltung, sanftes Nachladen von Bildern — all das kann per Skript passieren. Der eigentliche Inhalt, also die Aussagen, Fakten und Argumente einer Seite, muss ohne einen einzigen Skript-Aufruf vollständig vorhanden sein. Diese Trennung nennt man Progressive Enhancement: eine solide HTML-Grundlage, die für alle funktioniert, veredelt durch optionale Schichten für jene, die sie verarbeiten können.
Die Begriffe sauber getrennt:
- Markdown-Twin — eine parallele Klartext-Fassung einer Seite in Markdown, ausgeliefert per Content Negotiation oder als
.md-Zwilling. - Content-Parität — die Deckungsgleichheit zwischen sichtbarem, gerendertem Inhalt und rohem, ohne JavaScript ausgeliefertem HTML.
- Progressive Enhancement — das Prinzip, funktionierendes HTML als Fundament zu bauen und JavaScript nur als optionale Veredelung obendrauf zu legen.
- Client-Side Rendering — das Gegenteil: Der Inhalt wird erst im Browser per JavaScript erzeugt und fehlt im ausgelieferten HTML — der häufigste Bruch der Content-Parität.
Warum zählt das für KI-Crawler?
Viele KI-Crawler führen kein oder nur eingeschränkt JavaScript aus — steht der Inhalt nicht im HTML, sehen sie eine leere Seite. Anders als moderne Suchmaschinen-Renderer arbeiten die Bots hinter KI-Antwortmaschinen oft mit einem schlanken Fetch: Sie holen das rohe HTML, extrahieren den Text und ziehen weiter. Rechenintensive JavaScript-Ausführung ist bei Milliarden von Seiten schlicht zu aufwendig.
Die Folge ist unmittelbar: Wird der Text einer Seite erst per Skript in den DOM geschrieben, ist er für diese Crawler nicht existent. Die Seite kann nicht verstanden, nicht zusammengefasst und nicht als Quelle zitiert werden — egal, wie gut der Inhalt für Menschen aussieht. Ein perfekt formulierter Ratgeber, der nur nach JavaScript-Ausführung erscheint, ist aus Sicht einer KI ein leeres Blatt.
Content-Parität ohne JavaScript ist damit die Voraussetzung dafür, überhaupt gelesen zu werden. Sie senkt die Cost of Retrieval — den Aufwand, mit dem eine Maschine die relevanten Fakten aus einer Seite herausholt — an ihrer empfindlichsten Stelle: Zwischen einer Seite, deren Text sofort im HTML greifbar ist, und einer, die erst gerendert werden müsste, wählt ein KI-System unter Rechenbudget verlässlich die erste. Der Markdown-Twin verstärkt diesen Effekt, indem er den Kern zusätzlich in reinster Form serviert.
Wie prüfen Sie Content-Parität?
Content-Parität lässt sich in Minuten überprüfen, indem man die Seite so betrachtet, wie ein Crawler ohne JavaScript sie sieht. Vier Prüfungen genügen, um verlässlich zu beurteilen, ob der Inhalt einer Seite maschinenlesbar im HTML steht:
- JavaScript deaktivieren und neu laden — schalten Sie JavaScript in den Browser-Einstellungen ab und öffnen Sie die Seite erneut. Bleibt der Haupttext samt Überschriften und Absätzen sichtbar, ist die Parität gegeben. Verschwindet der Inhalt oder erscheint nur ein Ladebalken, hängt er am Skript.
- Quelltext ansehen — öffnen Sie den View-Source-Quelltext (in den meisten Browsern mit Strg+U beziehungsweise Cmd+Option+U). Suchen Sie im rohen HTML nach einem markanten Satz aus dem sichtbaren Text. Finden Sie ihn, steht er im HTML; finden Sie nur leere Container und Skript-Tags, fehlt er.
- Roh-HTML per curl abrufen — der Befehl
curl -s https://ihre-seite.ch/holt das HTML ohne jede JavaScript-Ausführung, genau wie ein schlanker Crawler. Was hier nicht auftaucht, sieht auch der Bot nicht. - Gerendert gegen roh vergleichen — in den Entwicklerwerkzeugen zeigt die Registerkarte «Elements» das gerenderte DOM, «View Source» das rohe HTML. Grosse Unterschiede beim Textinhalt sind ein direkter Beleg für fehlende Parität.
Wichtig ist die Unterscheidung, die diese Tests offenlegen: Sichtbarer Inhalt entsteht entweder serverseitig (steht im HTML, Parität erfüllt) oder clientseitig (entsteht erst im Browser, Parität verletzt). Nur der erste Fall macht eine Seite für die Breite der KI-Crawler zuverlässig lesbar.
Wie setzen Sie Markdown-Twins und Parität um?
Content-Parität entsteht am zuverlässigsten dadurch, dass der Inhalt von vornherein im HTML ausgeliefert wird — nicht durch nachträgliches Reparieren clientseitiger Seiten. Die Umsetzung folgt einer klaren Reihenfolge, vom Fundament zur Kür:
- HTML als Fundament — schreiben Sie die Inhalte direkt ins HTML, statt sie per Framework im Browser zu erzeugen. Handcodierte statische Seiten oder serverseitiges Rendering liefern den Text roh aus; reine Single-Page-Apps ohne Pre-Rendering brechen die Parität systematisch.
- Semantische Struktur — nutzen Sie echte Überschriften-Hierarchie, Absätze, Listen und Links statt
div-Suppe. Sauberes semantisches HTML macht die Bedeutung explizit und erleichtert die spätere Ableitung des Markdown-Twins. - JavaScript nur als Veredelung — halten Sie Skripte auf optionale Verbesserungen beschränkt: Theme-Umschaltung, sanfte Einblendungen, Interaktivität. Der Inhalt bleibt auch bei deaktiviertem JavaScript vollständig.
- Markdown-Twin bereitstellen — legen Sie zu jeder Kernseite eine
.md-Fassung mit identischem Text an oder richten Sie Content Negotiation ein, sodass einAccept: text/markdown-Header die Markdown-Variante zurückgibt. Der Twin muss inhaltlich deckungsgleich mit der HTML-Seite sein — sonst entsteht ein Widerspruch, den Maschinen misstrauisch abwägen. - Konsistenz absichern — halten Sie HTML-Seite und Markdown-Twin bei jeder Änderung synchron. Ein veralteter Twin ist schlechter als keiner, weil er falsche Fakten als «offizielle» Klartext-Quelle ausgibt.
Der Markdown-Twin greift dabei mit den übrigen Bausteinen der maschinenlesbaren Schicht ineinander: Er liefert den Fliesstext, JSON-LD @graph liefert die strukturierten Entitäten dazu, und llms.txt bündelt beides auf Site-Ebene zur kuratierten Übersicht. Content-Parität ist das gemeinsame Fundament: Ohne Inhalt im HTML läuft jede weitere Massnahme ins Leere.
Was beweisen diese Seiten selbst?
Die Wissens-Seiten von Studio Erdinc liefern ihren gesamten inhaltlichen Kern ohne JavaScript — der Text, den Sie lesen, steht bereits roh im ausgelieferten HTML. Deaktivieren Sie JavaScript und laden Sie neu: Überschriften, Definitionen, Listen und Fliesstext bleiben vollständig sichtbar. Das eingebundene doc.js steuert ausschliesslich Kür — Theme-Umschaltung und sanfte Einblendungen beim Scrollen — und ist für die Substanz der Seite nie Voraussetzung.
Das ist bewusst so gebaut: Diese Seiten sind handcodiert, ohne schweres Framework, und erreichen bei Lighthouse je 100 in Accessibility, Best Practices und SEO, gemessen am 3. September 2026 mit Lighthouse 13.4.1. Schnelle, sauber strukturierte, ohne JavaScript vollständig lesbare Seiten sind strukturell im Vorteil, wenn KI-Systeme unter Rechenbudget entscheiden, welche Quelle sie heranziehen. Content-Parität ist hier kein nachträglicher Anspruch, sondern die Standardvorgabe jeder Seite, die Studio Erdinc baut.
Häufige Fragen
- Was ist ein Markdown-Twin?
- Ein Markdown-Twin ist eine saubere Markdown-Fassung einer HTML-Seite, die denselben Inhalt ohne Layout-, Navigations- und Skript-Rauschen enthält. Er wird über Content Negotiation ausgeliefert oder als paralleler Zwilling mit .md-Endung bereitgestellt und gibt KI-Agenten den zitierfähigen Kern der Seite in ihrem bevorzugten Format.
- Was bedeutet Content-Parität ohne JavaScript?
- Content-Parität ohne JavaScript bedeutet, dass alle relevanten Inhalte einer Seite bereits im ausgelieferten HTML stehen und nicht erst per JavaScript nachgeladen werden. Der Text, den ein Mensch nach dem Rendern sieht, muss deckungsgleich mit dem sein, was ein Crawler ohne JavaScript-Ausführung im Quelltext vorfindet. JavaScript darf verbessern, ist aber nie Voraussetzung für die Substanz.
- Warum ist Content ohne JavaScript für KI-Crawler wichtig?
- Viele KI-Crawler führen kein oder nur eingeschränkt JavaScript aus. Wenn der Text einer Seite erst per Skript in den DOM geschrieben wird, sehen diese Crawler eine leere oder unvollständige Seite und können den Inhalt nicht zitieren. Steht der Inhalt bereits im HTML, wird er verlässlich gelesen — das senkt die Cost of Retrieval und erhöht die Chance, als Quelle genannt zu werden.
- Wie prüfe ich, ob meine Seite ohne JavaScript funktioniert?
- Der schnellste Test ist, JavaScript im Browser zu deaktivieren und die Seite neu zu laden: Bleibt der Haupttext sichtbar, ist die Content-Parität gegeben. Zusätzlich zeigt der Blick in den View-Source-Quelltext (Strg+U), ob der Text roh im HTML steht oder fehlt. Werkzeuge wie curl ohne JavaScript-Rendering oder die Prüfung der gerenderten gegenüber dem rohen HTML in den Entwicklerwerkzeugen bestätigen den Befund objektiv.
- Brauche ich Markdown-Twins, wenn ich schon llms.txt habe?
- llms.txt und Markdown-Twins ergänzen sich, ersetzen einander aber nicht. llms.txt gibt einer KI eine kuratierte Übersicht der wichtigsten Inhalte einer ganzen Website an einem zentralen Ort. Ein Markdown-Twin liefert dagegen den vollständigen, zitierfähigen Text einer einzelnen Seite in ihrem bevorzugten Format. Beide senken die Cost of Retrieval — llms.txt auf Site-Ebene, der Markdown-Twin auf Seitenebene.
Quellen
Belegstellen dieses Beitrags mit Organisation, Jahr und Link; eigene Erhebungen mit Methode und Datum. Geprüft am 6. September 2026.
- Vercel und MERJ: The rise of the AI crawler (Crawler-Studie: JavaScript-Rendering von GPTBot, ClaudeBot, Meta, Bytespider, PerplexityBot), 2024. vercel.com
- Chrome for Developers: Lighthouse overview, 2026. developer.chrome.com
- Studio Erdinc: Eigene Lighthouse- und PageSpeed-Messungen, dokumentiert mit Datum, Gerät und Werkzeug, 2026. lighthouse-100.html
Prüfen wir, wie eine KI Ihre Website liest
Im kostenlosen Erstgespräch zeigen wir, ob Ihr Inhalt ohne JavaScript ankommt — und welche Bausteine zur mühelosen Zitierbarkeit fehlen.
Kostenloses Erstgespräch