WISSEN · GEO
Was ist Cost of Retrieval?
Cost of Retrieval ist der Aufwand, den eine Suchmaschine oder ein KI-System betreiben muss, um die relevante Information aus einer Webseite zu finden, zu extrahieren und zu verstehen. Der Begriff stammt aus der Semantic-SEO-Methodik von Koray Tugberk Gübür — und die Regel dahinter ist simpel: Je niedriger die Cost of Retrieval, desto besser für Ranking und für Zitate in KI-Antworten. Dieser Ratgeber erklärt die Definition, warum sie zählt, welche sechs Faktoren sie bestimmen und wie man sie senkt.
- Was ist Cost of Retrieval?
- Warum eine niedrige Cost of Retrieval Rankings und KI-Zitate hebt
- Die sechs Faktoren, die die Cost of Retrieval bestimmen
- Wie Sie die Cost of Retrieval Ihrer Website senken
- Wie Studio Erdinc die Abrufkosten im Handwerk senkt
- Cost of Retrieval, Topical Authority und GEO
- Häufige Fragen
- Quellen
Was ist Cost of Retrieval?
Cost of Retrieval ist der Aufwand, den eine Suchmaschine oder ein KI-System betreiben muss, um die relevante Information aus einer Webseite zu finden, zu extrahieren und zu verstehen. Der Begriff — auf Deutsch «Abrufkosten» — stammt aus der Semantic-SEO-Methodik des Strategen Koray Tugberk Gübür und beschreibt die Reibung zwischen einer Maschine und dem Inhalt einer Seite.
Ein Bild macht es greifbar: Stellen Sie sich zwei Bücher zum gleichen Thema vor. Das eine hat ein Inhaltsverzeichnis, klare Kapitelüberschriften und beantwortet jede Frage direkt im ersten Satz des Abschnitts. Das andere hat den gleichen Inhalt, aber ohne Gliederung, mit vergrabenen Kernaussagen und Seiten, die erst zusammengeklebt werden müssen, bevor man sie lesen kann. Beide enthalten dieselbe Information — doch das erste ist billiger auszuwerten. Genau diese «Auswertungskosten» meint die Cost of Retrieval, übertragen auf Crawler und KI-Modelle.
Weil moderne Suchmaschinen und KI-Antwortmaschinen jede gecrawlte Seite verarbeiten müssen, ist dieser Aufwand kein Nebenschauplatz, sondern ein direkter Rankingfaktor. Cost of Retrieval ist einer der drei Hebel in Gübürs Formel für Topical Authority nach Koray Tugberk Gübür — und der einzige, den sauberes technisches Handwerk sofort verbessern kann.
Warum sind niedrige Abrufkosten für Ihre Sichtbarkeit entscheidend?
Niedrige Abrufkosten sind für Ihre Sichtbarkeit entscheidend, weil ein günstig abrufbares Dokument eher zitiert wird als ein teures — bei genau gleichem Inhalt. Der Grund steht in der Formel: Topical Authority = (Topical Coverage × Historical Data) / Cost of Retrieval. Die Abrufkosten stehen im Nenner — jede Senkung hebt bei gleichem Inhalt die gesamte Autorität. Content-Vollständigkeit und historische Verlässlichkeit brauchen Monate; die Extrahierbarkeit einer Seite lässt sich dagegen sofort optimieren.
Praktisch wirkt sich das an drei Stellen aus. Erstens beim Crawl-Budget: Suchmaschinen crawlen nicht unbegrenzt. Seiten, die billig auszuwerten sind, werden häufiger und vollständiger erfasst als solche, die teuer im Abruf sind. Zweitens bei der Interpretation: Kann ein System die Kernaussage einer Seite eindeutig und ohne Umwege extrahieren, wird sie verlässlicher dem richtigen Thema zugeordnet und für die passenden Fragen ausgespielt. Drittens — und heute entscheidend — bei KI-Zitaten: Antwortmaschinen wie Google AI Overviews, ChatGPT, Perplexity oder Gemini zitieren bevorzugt Quellen, deren belastbare Aussagen sie sauber herauslösen können. Was Maschinen mühelos lesen, zitieren sie eher. Diese Ausrichtung auf Zitierfähigkeit ist der Kern von Generative Engine Optimization (GEO).
Welche Faktoren bestimmen die Cost of Retrieval einer Website?
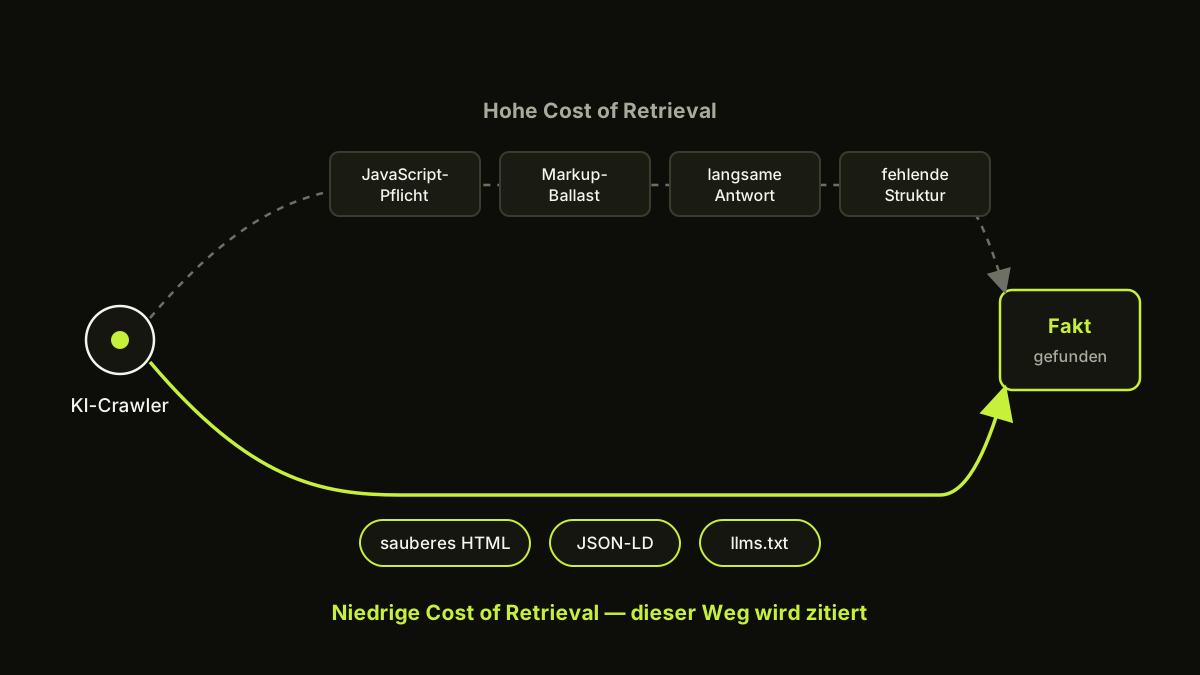
Sechs Faktoren bestimmen die Cost of Retrieval einer Seite: sauberes HTML, Inhalts-Parität ohne JavaScript, klare Struktur, Ladegeschwindigkeit, maschinenlesbare strukturierte Daten und maschinenlesbare Wegweiser wie llms.txt. Jeder Faktor senkt oder erhöht die Reibung an einer anderen Stelle des Abrufprozesses — vom Herunterladen der Seite bis zum Verstehen ihrer Bedeutung.
- Sauberes, semantisches HTML: Klare Tags wie
<article>,<h1>bis<h6>,<nav>oder<dl>sagen einer Maschine, was welche Rolle spielt. Ein Wust aus bedeutungslosen<div>-Containern zwingt sie zum Raten — das kostet. - Zero-JS-Parität (Inhalt ohne JavaScript): Steht der vollständige Kerninhalt bereits im ausgelieferten HTML, kann er ohne teure Rendering-Runde gelesen werden. Entsteht der Inhalt erst durch JavaScript im Browser, steigen die Abrufkosten stark — und viele KI-Crawler rendern gar kein JavaScript.
- Klare inhaltliche Struktur: Eine logische Überschriften-Hierarchie und Abschnitte, die mit einem self-contained Antwort-Satz beginnen (Inverted Pyramid), machen die Kernaussage sofort auffindbar, statt sie im dritten Absatz zu vergraben.
- Ladegeschwindigkeit und Core Web Vitals: Schnelle, ressourcenschonende Seiten sind pro Abruf günstiger und werden gründlicher gecrawlt. Ein perfekter Lighthouse-100-Score ist der messbare Beleg dafür.
- Maschinenlesbare strukturierte Daten (JSON-LD): Schema.org-Auszeichnung übersetzt Inhalte in ein Format, das Maschinen ohne Interpretation lesen — vorausgesetzt, die Daten sind wortgleich zum sichtbaren Text. Widersprechen sich Schema und Text, steigt die Cost of Retrieval statt zu sinken.
- Maschinenlesbare Wegweiser (llms.txt, robots.txt): Eine llms.txt-Datei und eine saubere robots.txt zeigen KI-Crawlern direkt, wo die wichtigen, kuratierten Inhalte liegen — statt sie die ganze Site absuchen zu lassen.
Ein siebter, verwandter Hebel sind die Markdown-Twins: eine parallele, reine Textfassung jeder Seite, die Crawlern eine formatierungsfreie, besonders billig auszuwertende Version anbietet. Wie diese Doppelfassung funktioniert, erklärt der Beitrag zu Markdown-Twins und Content-Parität.
Zusammen bilden llms.txt, Markdown-Zwillinge, JSON-LD und WebMCP als Werkzeug-Schnittstelle die Maschinenschicht einer Website; wie ein Agent sie tatsächlich durchläuft, beschreibt der Beitrag zum Agentic Browsing. Wie diese Schicht als Ganzes gebaut wird, steht bei agent-ready Webdesign.
Wie senken Sie die Cost of Retrieval Ihrer Website?
Sie senken die Cost of Retrieval Ihrer Website, indem Sie Seiten schlank handcodieren, den Kerninhalt ohne JavaScript verfügbar machen, jede Sektion mit einem klaren Antwort-Satz beginnen, die Ladezeit optimieren und strukturierte Daten wortgleich zum Text pflegen. Anders als Content-Vollständigkeit und Historical Data, die Zeit brauchen, ist die technische Extrahierbarkeit eine Frage der Umsetzung — sie lässt sich bei jeder Seite sofort verbessern.
- Handcodieren statt aufblähen: Schlanke, von Hand geschriebene Seiten ohne überflüssige Frameworks und Skripte liefern den Inhalt direkt aus. Weniger Ballast bedeutet weniger Abrufaufwand.
- Kerninhalt server-seitig ausliefern: Der vollständige Text steht im HTML, das der Server sendet. JavaScript verbessert das Erlebnis, ist aber nie Voraussetzung, um den Inhalt zu lesen — das ist Zero-JS-Parität.
- Antworten nach vorne (Inverted Pyramid): Jeder Abschnitt beginnt mit einem self-contained Satz, der die Frage direkt beantwortet. So findet eine Maschine die zitierfähige Kernaussage ohne Suche.
- Auf die Lighthouse-Werte und die Core Web Vitals optimieren: Bilder, Schriften und Code werden so ausgeliefert, dass die Seite schnell und stabil lädt — messbar im Lighthouse-Report.
- Strukturierte Daten wortgleich pflegen: JSON-LD nach Schema.org spiegelt exakt den sichtbaren Text. FAQ-Antworten im Schema sind identisch mit dem Text auf der Seite — keine erfundenen Angaben.
- KI-Crawlern Wegweiser geben: Eine llms.txt listet die kuratierten Kerninhalte, die robots.txt erlaubt seriösen KI-Bots wie ClaudeBot und GPTBot ausdrücklich den Zugriff. Diese Massnahmen fasst das Feld agent-ready Webdesign zusammen.
Wichtig zur Einordnung: Cost of Retrieval senken heisst nicht, Inhalt zu kürzen. Es heisst, denselben — gern umfangreichen — Inhalt so aufzubereiten, dass Maschinen ihn mit minimaler Reibung lesen. Vollständige Coverage und niedrige Abrufkosten sind kein Widerspruch, sondern das Ziel: viel Substanz, sauber verpackt.
Wie senkt Studio Erdinc die Abrufkosten im Handwerk?
Studio Erdinc senkt die Abrufkosten dadurch, dass jede Seite handcodiert entsteht — der Inhalt steht ohne JavaScript im HTML, und das ist der Grund, warum eine handcodierte Website niedrige Abrufkosten hat. Sie werden nicht nachträglich eingebaut, sondern entstehen von der ersten Zeile an. Weil die Abrufkosten im Nenner der Autoritätsformel stehen, ist sauberes technisches Handwerk der direkteste Hebel, den ein Studio überhaupt bedienen kann.
Konkret bedeutet das: statische, handgeschriebene HTML-Seiten mit sauberer semantischer Struktur, strukturierte Daten (JSON-LD) wortgleich zum sichtbaren Text, eine llms.txt als Wegweiser für KI-Crawler, Schweizer Hosting und je 100 in den Lighthouse-Kategorien Accessibility, Best Practices und SEO. So wird derselbe Content für Google und für KI-Systeme günstig abrufbar — und bei gleicher Themenabdeckung steigt die Autorität. Diese Bauweise ist kein Add-on, sondern der Standard bei jedem Projekt aus Wetzikon im Zürcher Oberland. Die Abrufkosten sind dabei nur der Nenner der Formel; was im Zähler steht — die Themenabdeckung —, ist Gegenstand von Semantic SEO nach der Methodik von Koray Tugberk Gübür.
Wie verhält sich Cost of Retrieval zu Topical Authority und GEO?
Cost of Retrieval ist ein Kostenmass des Abrufs, kein Mass der thematischen Abdeckung — sie sagt, wie teuer eine Antwort aus Ihrer Seite zu holen ist, nicht, wie vollständig Ihr Thema abgedeckt ist. In der Formel stehen beide Grössen, aber an verschiedenen Stellen: Die Themenabdeckung steht im Zähler, die Abrufkosten im Nenner. Wer die Abrufkosten senkt, macht dieselbe Abdeckung wirksamer; er erzeugt keine zusätzliche.
Daraus folgt die Beziehung zur Topical Authority: Sinkende Abrufkosten erhöhen die Wahrscheinlichkeit, zitiert zu werden — sie ersetzen die Abdeckung aber nicht. Eine perfekt ausgelieferte Seite zu einem Thema, das die Website sonst nicht behandelt, bleibt eine einzelne Seite. Die Methodik hinter der Abdeckung steht bei Topical Authority und ihren drei Hebeln.
Zu GEO steht sie in einem anderen Verhältnis: Abrufkosten sind eine Voraussetzung, kein Ziel. GEO und AEO fragen, ob eine Aussage in einer generierten Antwort landet; die Abrufkosten entscheiden vorher darüber, ob sie überhaupt gelesen wird. Wie sich die Disziplinen zueinander verhalten, trennt der Beitrag SEO, GEO, AEO und LLMO im Einzelnen; wie ein Modell die gelesenen Quellen dann verwendet, beschreibt Retrieval Augmented Generation.
- Cost of Retrieval
- Der Aufwand, den eine Suchmaschine oder ein KI-System betreiben muss, um Information aus einer Seite zu finden, zu extrahieren und zu verstehen — je niedriger, desto besser.
- Zero-JS-Parität
- Der vollständige Kerninhalt einer Seite steht bereits im ausgelieferten HTML und ist ohne JavaScript lesbar; Skript dient nur der Verbesserung, nie als Voraussetzung.
- Semantisches HTML
- Auszeichnung mit bedeutungstragenden Tags (z. B. article, nav, h1–h6, dl), die einer Maschine die Rolle jedes Elements ohne Raten mitteilen.
- Inverted Pyramid
- Schreibprinzip, bei dem die wichtigste, zitierfähige Antwort am Anfang eines Abschnitts steht und Details danach folgen.
- JSON-LD
- Maschinenlesbares Format für strukturierte Daten nach Schema.org; senkt die Abrufkosten nur, wenn es wortgleich zum sichtbaren Text ist.
- llms.txt
- Eine Textdatei im Wurzelverzeichnis, die KI-Crawlern die kuratierten Kerninhalte einer Website als Wegweiser auflistet.
Häufige Fragen zur Cost of Retrieval
- Was ist Cost of Retrieval?
- Cost of Retrieval ist der Aufwand, den eine Suchmaschine oder ein KI-System betreiben muss, um die relevante Information aus einer Webseite zu finden, zu extrahieren und zu verstehen. Der Begriff stammt aus der Semantic-SEO-Methodik von Koray Tugberk Gübür. Je niedriger die Cost of Retrieval, desto verlässlicher wird eine Seite verarbeitet, gerankt und in KI-Antworten zitiert.
- Warum ist eine niedrige Cost of Retrieval wichtig für Ranking und KI-Zitate?
- Weil die Cost of Retrieval in der Formel für Topical Authority im Nenner steht: Topical Authority = (Topical Coverage × Historical Data) / Cost of Retrieval. Jede Senkung der Abrufkosten hebt bei gleichem Inhalt die gesamte Autorität. Eine Seite, deren Kernaussagen ein Crawler ohne Umwege extrahieren kann, wird zuverlässiger indexiert und von KI-Antwortmaschinen eher als Quelle zitiert als eine, deren Inhalt hinter JavaScript oder unklarer Struktur verborgen liegt.
- Welche Faktoren bestimmen die Cost of Retrieval?
- Sechs Faktoren bestimmen die Cost of Retrieval: sauberes, semantisches HTML; Inhalts-Parität ohne JavaScript (Zero-JS-Parität); eine klare inhaltliche Struktur mit sinnvoller Überschriften-Hierarchie und Antworten am Anfang; die Ladegeschwindigkeit und Core Web Vitals; maschinenlesbare strukturierte Daten (JSON-LD), die wortgleich zum sichtbaren Text sind; und maschinenlesbare Wegweiser wie eine llms.txt-Datei und eine saubere robots.txt.
- Wie senkt man die Cost of Retrieval einer Website?
- Man senkt die Cost of Retrieval, indem man Seiten handcodiert und schlank hält, den Kerninhalt bereits im ausgelieferten HTML ohne JavaScript verfügbar macht, jede Sektion mit einem self-contained Antwort-Satz beginnt, die Ladezeit mit Blick auf die Lighthouse-Werte und die Core Web Vitals optimiert, strukturierte Daten wortgleich zum sichtbaren Text pflegt und KI-Crawlern mit llms.txt und robots.txt klare Wegweiser gibt.
- Was hat JavaScript mit der Cost of Retrieval zu tun?
- JavaScript erhöht die Cost of Retrieval, wenn der eigentliche Inhalt erst im Browser durch Skript-Ausführung entsteht. Ein Crawler muss dann eine vollständige Rendering-Runde durchlaufen, was aufwändiger, langsamer und fehleranfälliger ist als das Lesen von fertigem HTML. Viele KI-Crawler rendern gar kein JavaScript. Zero-JS-Parität bedeutet, dass der vollständige Kerninhalt bereits im ausgelieferten HTML steht und JavaScript nur zur Verbesserung dient — das senkt die Abrufkosten deutlich.
Quellen
Belegstellen dieses Beitrags mit Organisation, Jahr und Link; eigene Erhebungen mit Methode und Datum. Geprüft am 6. September 2026.
- Koray Tugberk Gübür: Holistic SEO & Digital — Topical Authority und Semantic SEO, 2026. holisticseo.digital
- Chrome for Developers: Lighthouse overview, 2026. developer.chrome.com
- web.dev (Google): Web Vitals, 2026. web.dev
- Schema.org: About Schema.org, 2011. schema.org
- llmstxt.org: The /llms.txt file — Vorschlag, 2024. llmstxt.org
Senken Sie die Abrufkosten Ihrer Website
In einem kostenlosen Erstgespräch prüfen wir, wie teuer Ihre Seiten für Google und KI im Abruf sind — und wie handcodiertes Webdesign das ändert.
Kostenloses Erstgespräch