WISSEN · STRUKTURIERTE DATEN
Was sind JSON-LD und strukturierte Daten? (2026)
Strukturierte Daten sind maschinenlesbare Zusatzinformationen im Quelltext einer Website, die Suchmaschinen und KI-Systemen eindeutig sagen, was auf der Seite steht — welches Unternehmen, welche Dienstleistung, welche Person. JSON-LD ist das von Google empfohlene Format dafür, Schema.org das gemeinsame Vokabular. Richtig eingesetzt machen sie eine Seite besser verständlich, zitierfähiger und öffnen die Tür zu Rich Results.
- Was sind strukturierte Daten?
- JSON-LD und Schema.org: Format und Vokabular
- Warum sie Suchmaschinen und KI helfen
- Schema-Text-Alignment: Schema muss zum Text passen
- Wichtige Schema-Typen für KMU
- Die @graph-Idee: ein Wissensgraph der Website
- Typische Fehler — und wie wir es machen
- Begriffe kurz erklärt
- Häufige Fragen
- Quellen
Was sind strukturierte Daten?
Strukturierte Daten sind maschinenlesbare Zusatzinformationen im Quelltext einer Website, die den Inhalt einer Seite explizit und eindeutig beschreiben. Für Besucher sind sie unsichtbar; für Suchmaschinen und KI-Systeme verwandeln sie einen Absatz Fliesstext in klar benannte Fakten. Wo ein Mensch aus «Studio Erdinc, Wetzikon, Webdesign» mühelos ein Unternehmen, einen Ort und eine Leistung erkennt, muss eine Maschine raten — es sei denn, die Seite sagt es ausdrücklich über strukturierte Daten.
Der Unterschied ist der zwischen einer Zeichenkette und einem benannten Ding. Ohne Markup liest ein Crawler nur Wörter und muss aus dem Kontext schliessen, worum es geht. Mit Markup steht im Quelltext: Dies ist ein LocalBusiness mit dem Namen «Studio Erdinc», der Adresse in Wetzikon und der Dienstleistung «Webdesign». Aus Interpretation wird Gewissheit — und Gewissheit ist genau das, was Such- und Antwortsysteme brauchen, um eine Seite verlässlich einzuordnen und zu zitieren.
Was ist der Unterschied zwischen JSON-LD und Schema.org?
Schema.org ist das Vokabular, JSON-LD das Format: Schema.org legt fest, welche Typen und Eigenschaften es gibt, JSON-LD legt fest, wie man sie in eine Website schreibt. Die beiden gehören zusammen wie eine Sprache und ihre Schrift. Schema.org ist ein gemeinsames Vokabular, das 2011 von Google, Microsoft, Yahoo und Yandex ins Leben gerufen wurde und Begriffe wie LocalBusiness, Service, Person oder address definiert. JSON-LD (JavaScript Object Notation for Linked Data) ist die Notation, in der dieses Vokabular in einen unsichtbaren script-Block im Quelltext geschrieben wird.
Es gibt auch ältere Formate wie Microdata und RDFa, die das Markup direkt in die HTML-Tags mischen. Google empfiehlt jedoch ausdrücklich JSON-LD, weil es sauber vom sichtbaren HTML getrennt in einem eigenen Block steht, leicht zu pflegen ist und den Rest der Seite nicht verändert. Genau deshalb setzen wir bei Studio Erdinc konsequent auf JSON-LD — es lässt sich beim Handcodieren präzise kontrollieren und mit dem sichtbaren Inhalt in Einklang halten.
Warum helfen strukturierte Daten Suchmaschinen und KI?
Strukturierte Daten helfen, weil sie Entitäten und ihre Beziehungen eindeutig benennen — und damit gleichzeitig Rich Results in der Suche, ein besseres Entitäts-Verständnis und die Zitierbarkeit in KI-Antworten ermöglichen. Sie wirken auf drei Ebenen, die sich gegenseitig verstärken.
Erstens ermöglichen sie Rich Results: erweiterte Suchergebnisse wie Breadcrumb-Pfade, Bewertungssterne oder Firmen-Angaben, die aus dem Markup gespeist werden. Zweitens verbessern sie das Entitäts-Verständnis: Eine Suchmaschine, die per Markup weiss, dass eine Seite von einer bestimmten Person geschrieben wurde und ein bestimmtes Unternehmen beschreibt, kann diese Entitäten mit ihrem Wissensgraph abgleichen und sicherer einordnen. Drittens steigern sie die Zitierbarkeit für KI: KI-Antwortmaschinen wie ChatGPT, Perplexity und Google AI Overviews erkennen klar ausgezeichnete Fakten schneller und sicherer, was die Cost of Retrieval senkt — den Aufwand, aus einer Seite verlässliche Informationen zu ziehen. Eine Voraussetzung sind sie dafür nicht: Für AI Overviews und AI Mode nennt Google keine besonderen strukturierten Daten (Google Search Central, «AI Optimization Guide», Stand 10. Juli 2026). Wie strukturierte Daten in die grössere Strategie passen, in KI-Antworten zitiert zu werden, vertieft unser Ratgeber dazu, in KI-Antworten zitiert zu werden.
Was bedeutet Schema-Text-Alignment?
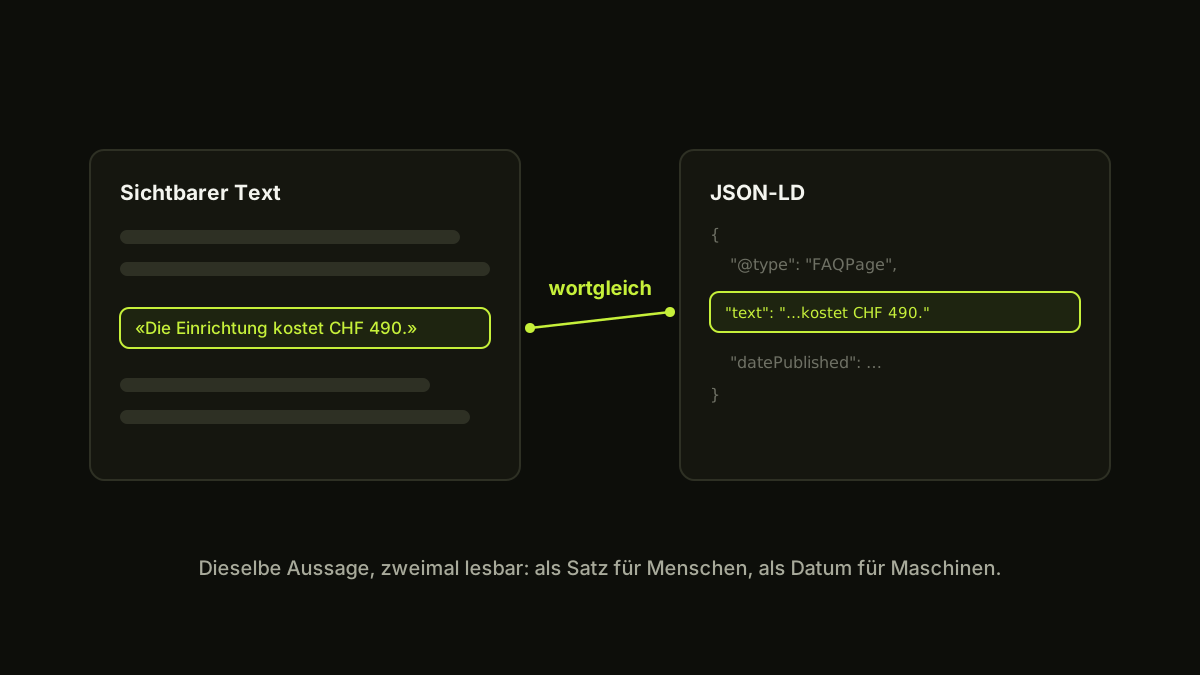
Schema-Text-Alignment ist das Prinzip, dass strukturierte Daten den sichtbaren Inhalt der Seite widerspiegeln müssen — das Markup darf nichts behaupten, was auf der Seite nicht steht. Google formuliert das in seinen Richtlinien für strukturierte Daten ausdrücklich: Markierte Inhalte müssen für Nutzer sichtbar sein, und das Markup muss den tatsächlichen Seiteninhalt repräsentieren. Eine FAQ-Antwort im JSON-LD muss also wortgleich zu dem sein, was der Besucher im sichtbaren FAQ-Block liest.
Der Grund ist nicht nur Regeltreue, sondern Vertrauen. Wenn Markup und sichtbarer Text auseinanderlaufen — etwa fünf Sterne im Schema, aber keine Bewertungen auf der Seite —, wertet Google das als irreführend und kann eine manuelle Massnahme verhängen, die Rich Results entfernt. KI-Systeme reagieren ähnlich empfindlich: Widersprüche zwischen Markup und Inhalt untergraben die Verlässlichkeit einer Quelle. Deshalb ist unsere Regel eindeutig: Wir erfinden im Schema keine Fakten und keine Bewertungen. Jede Aussage im Markup hat ihre sichtbare Entsprechung im Text — das ist die technische Seite der zitierfähigen, ehrlichen Inhalte, die Semantic SEO nach Koray Tugberk Gübür verlangt.
Welche Schema-Typen braucht ein KMU?
Für die meisten kleinen und mittleren Unternehmen genügen fünf gut gepflegte Schema-Typen: LocalBusiness, Service, FAQPage, BreadcrumbList und Person. Weniger, aber korrekte und zum Text passende Typen sind wertvoller als eine lange Liste oberflächlicher Auszeichnungen. Diese fünf decken ab, was ein lokales Dienstleistungs-Unternehmen wirklich braucht:
- LocalBusiness — beschreibt das Unternehmen selbst mit Name, Adresse, Ort, Öffnungszeiten und Kontaktdaten. Für viele Branchen gibt es passendere Unterklassen; wichtig ist, dass die Angaben mit Impressum und Google Business Profil übereinstimmen.
- Service — beschreibt eine einzelne Leistung, etwa «Webdesign» oder «GEO-Optimierung», mit Anbieter, Beschreibung und bedientem Gebiet. So wird klar, was das Unternehmen anbietet.
- FAQPage — zeichnet Frage-Antwort-Blöcke aus. Die Antworten im Markup müssen wortgleich zum sichtbaren Text sein. FAQ-Rich-Results zeigt Google seit dem 7. Mai 2026 nicht mehr an (Google Search Central, Changelog). Als Frage-Antwort-Struktur bleibt der Block für andere Antwortmaschinen lesbar.
- BreadcrumbList — bildet den Navigationspfad einer Seite ab (etwa Startseite → Wissen → diese Seite) und hilft Such- und KI-Systemen, die Position der Seite in der Website-Struktur zu verstehen.
- Person — beschreibt die Gründerin oder den Gründer als Autor und Fachperson. Sie ist zentral für E-E-A-T, weil sie Inhalte an eine reale, benennbare Person bindet.
Studio Erdinc verwendet genau diese Bausteine über die gesamte Website konsistent: die zentrale Entität einmal sauber definiert, jede Seite mit passendem Typ und Breadcrumb, jeder Autor als Person. Wie diese maschinenlesbare Schicht insgesamt aufgebaut ist, damit KI-Crawler sie mühelos lesen, zeigt unser Ratgeber zum agent-ready Webdesign.
Was ist die @graph-Idee?
@graph ist eine JSON-LD-Schreibweise, mit der mehrere Entitäten in einem einzigen script-Block beschrieben und über @id miteinander verknüpft werden — sie bildet einen kleinen Wissensgraphen der Website ab. Statt Unternehmen, Person und Seite in getrennten, teils redundanten Blöcken zu notieren, definiert man jede Entität genau einmal mit einer eigenen, stabilen @id und referenziert sie überall dort, wo sie gebraucht wird.
Das Prinzip lässt sich an dieser Website zeigen: Die Person «Özden Erdinc» wird einmal auf der Startseite unter der @id https://studioerdinc.ch/#oezden definiert, das Studio unter #studio, die Website unter #website. Jede weitere Seite — auch diese Wissensseite — erfindet diese Entitäten nicht neu, sondern verweist per @id darauf. So bleibt der Autor überall dieselbe Person und das Studio überall dasselbe Unternehmen, ohne Widersprüche und ohne Wiederholung. Für Suchmaschinen und KI ergibt sich daraus ein zusammenhängendes, widerspruchsfreies Bild der Entitäten und ihrer Beziehungen — genau die Struktur, die eine Website als verlässliche Quelle auszeichnet.
Typische Fehler — und wie wir es machen
Die häufigsten Fehler bei strukturierten Daten sind erfundene Bewertungen, Markup ohne sichtbare Entsprechung und ein Wildwuchs unverbundener Typen — genau diese vermeiden wir bewusst. Erstens werden gern Bewertungssterne (AggregateRating) ausgezeichnet, für die es gar keine echten Bewertungen gibt; das verstösst gegen Googles Richtlinien und riskiert eine manuelle Massnahme. Zweitens wird Markup gesetzt, das auf der Seite gar nicht sichtbar ist — ein direkter Bruch des Schema-Text-Alignments. Drittens werden viele Typen lose nebeneinandergestellt, ohne sie über @id zu verknüpfen, sodass kein kohärentes Entitäts-Bild entsteht.
Unser Ansatz ist das Gegenteil: Wir erfinden keine Zahlen und keine Bewertungen, halten jedes Markup an einer sichtbaren Textstelle fest und verbinden alle Entitäten über einen sauberen @graph. Weil wir handcodieren, ist das Markup Teil der Seite und nicht das Zufallsprodukt eines Plugins — überprüfbar, konsistent und mit niedriger Cost of Retrieval. Das ist dieselbe Sorgfalt, mit der wir Seiten in den Lighthouse-Kategorien Accessibility, Best Practices und SEO auf je 100 bringen und für KI-Crawler auf Schweizer Hosting bereitstellen.
Begriffe kurz erklärt
- Strukturierte Daten
- Maschinenlesbare Zusatzinformationen im Quelltext, die den Inhalt einer Seite explizit beschreiben — für Besucher unsichtbar, für Maschinen eindeutig.
- Schema.org
- Das gemeinsame Vokabular strukturierter Daten mit Typen und Eigenschaften wie LocalBusiness, Service oder Person, 2011 von grossen Suchmaschinen begründet.
- JSON-LD
- JavaScript Object Notation for Linked Data — das von Google empfohlene Format, um Schema.org-Vokabular in einem eigenen, unsichtbaren script-Block einzubetten.
- Schema-Text-Alignment
- Das Prinzip, dass strukturierte Daten den sichtbaren Seiteninhalt widerspiegeln müssen — Markup darf nichts behaupten, was nicht auf der Seite steht.
- Rich Result
- Ein erweitertes Suchergebnis, das aus strukturierten Daten gespeist wird, etwa Breadcrumb-Pfad, Bewertungssterne oder Firmen-Angaben.
- @graph
- Eine JSON-LD-Schreibweise, die mehrere Entitäten in einem Block über stabile @id-Verweise verknüpft und so einen Wissensgraphen der Website bildet.
- @id
- Ein eindeutiger Bezeichner für eine Entität im Markup, über den dieselbe Entität an mehreren Stellen widerspruchsfrei referenziert wird.
- Cost of Retrieval
- Der Aufwand, den eine Suchmaschine oder ein KI-Crawler betreiben muss, um verlässliche Informationen aus einer Seite zu extrahieren — je niedriger, desto besser.
Häufige Fragen zu JSON-LD und strukturierten Daten
- Was ist JSON-LD?
- JSON-LD (JavaScript Object Notation for Linked Data) ist ein von Google empfohlenes Format, um strukturierte Daten nach dem Schema.org-Vokabular in eine Website einzubetten. Der Code steht in einem eigenen script-Block im Quelltext und beschreibt maschinenlesbar, was auf der Seite steht — etwa dass es sich um ein lokales Unternehmen, eine Dienstleistung oder eine Person handelt. Er ist für Besucher unsichtbar und ändert die Darstellung der Seite nicht.
- Was ist der Unterschied zwischen JSON-LD und Schema.org?
- Schema.org ist das Vokabular — die vereinbarte Liste von Typen und Eigenschaften wie LocalBusiness, Service oder address —, während JSON-LD das Format ist, in dem dieses Vokabular in eine Website geschrieben wird. Schema.org sagt, welche Begriffe es gibt; JSON-LD sagt, wie man sie notiert. Beide werden fast immer gemeinsam verwendet.
- Muss das Schema zum sichtbaren Text passen?
- Ja. Strukturierte Daten müssen den sichtbaren Inhalt der Seite widerspiegeln — dieses Prinzip heisst Schema-Text-Alignment. Google verlangt in seinen Richtlinien, dass markierte Inhalte für Nutzer sichtbar sind und dass das Markup den Seiteninhalt repräsentiert. FAQ-Antworten im Schema müssen daher wortgleich zum sichtbaren Text sein. Widersprüchliches oder erfundenes Markup kann zu einer manuellen Massnahme führen und untergräbt zusätzlich das Vertrauen von KI-Systemen.
- Welche Schema-Typen braucht ein KMU?
- Für die meisten kleinen und mittleren Unternehmen genügen wenige, gut gepflegte Typen: LocalBusiness (oder eine passende Unterklasse) für das Unternehmen mit Adresse und Öffnungszeiten, Service für einzelne Leistungen, FAQPage für Frage-Antwort-Blöcke, BreadcrumbList für die Navigationspfade und Person für die Gründerin oder den Gründer. Weniger, aber korrekte und zum Text passende Typen sind wertvoller als viele oberflächliche.
- Was ist der @graph in JSON-LD?
- @graph ist eine Schreibweise in JSON-LD, mit der mehrere Entitäten in einem einzigen script-Block beschrieben und über @id miteinander verknüpft werden. Statt Unternehmen, Person und Seite getrennt und redundant zu notieren, definiert man jede Entität einmal mit einer eigenen @id und referenziert sie an anderer Stelle. So entsteht ein kleiner, widerspruchsfreier Wissensgraph der Website, den Suchmaschinen und KI leichter auswerten.
- Bringt JSON-LD auch etwas für KI-Antworten?
- Ja. Strukturierte Daten helfen nicht nur klassischen Suchmaschinen, sondern auch KI-Antwortmaschinen wie ChatGPT, Perplexity und Google AI Overviews, die Entitäten einer Seite und ihre Beziehungen sicher zu erkennen. Klar ausgezeichnete Entitäten senken die Cost of Retrieval — den Aufwand, aus einer Seite verlässliche Fakten zu ziehen — und erhöhen so die Chance, dass die Seite als Quelle zitiert wird.
Quellen
Belegstellen dieses Beitrags mit Organisation, Jahr und Link; eigene Erhebungen mit Methode und Datum. Geprüft am 6. September 2026.
- W3C: JSON-LD 1.1, 2020. w3.org
- Schema.org: About Schema.org, 2011. schema.org
- Google Search Central: Introduction to structured data markup, 2026. developers.google.com
- Google Search Central: General structured data guidelines, 2026. developers.google.com
- Google Search Central: Search Central Changelog, 2026. developers.google.com
- Google Search Central: AI features and your website, 2026. developers.google.com
Sollen Ihre Inhalte maschinenlesbar werden?
In einem kostenlosen Erstgespräch klären wir, welche Schema-Typen Ihre Website braucht und wie wir sie sauber und wahrheitsgetreu umsetzen.
Kostenloses Erstgespräch