WISSEN · AGENT-READY
Was ist llms.txt? Zweck, Format, Beispiel (2026)
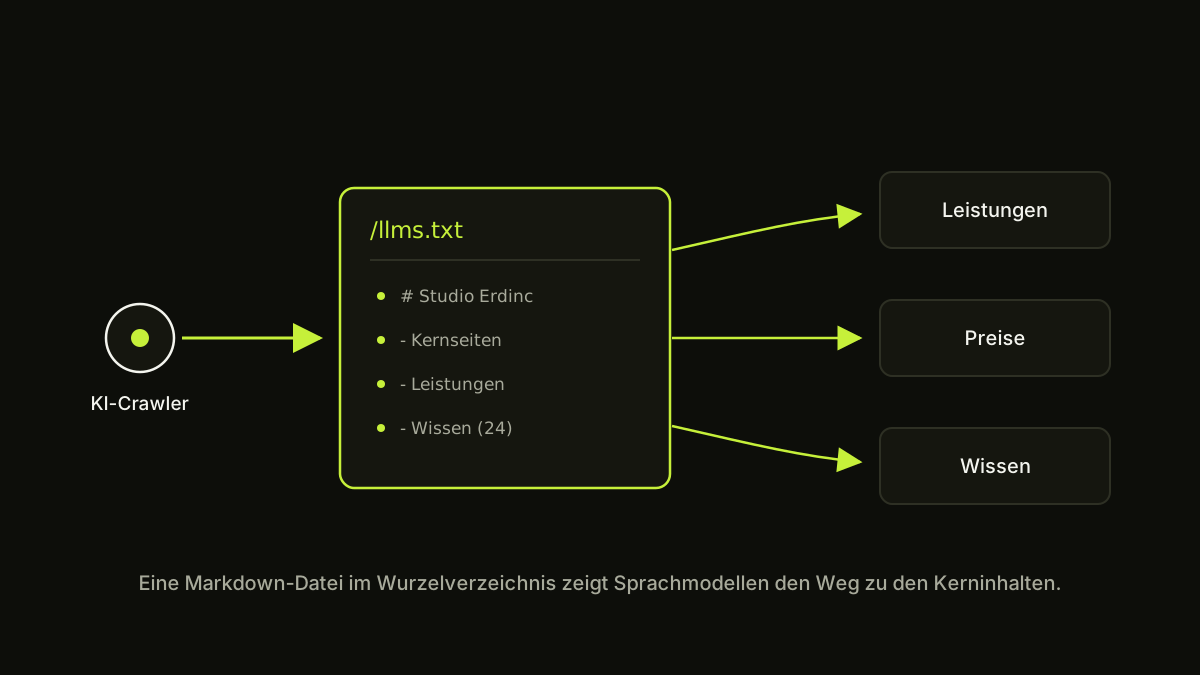
llms.txt ist eine Markdown-Datei im Wurzelverzeichnis einer Website, die KI-Agenten den Inhalt der Site strukturiert und kuratiert erschliesst — mit einer kurzen Beschreibung und einer geordneten Liste der wichtigsten Seiten. Sie senkt die Cost of Retrieval und macht die Kernfakten einer Domain für Sprachmodelle wie ChatGPT, Perplexity und Google AI Overviews leichter auffindbar und zitierbar.
- Definition
- Zweck
- Aufbau & Format
- Beispiel
- Abgrenzung zu robots.txt & sitemap.xml
- Wie Studio Erdinc es einsetzt
- Häufige Fragen
- Quellen
Was ist llms.txt?
llms.txt ist eine einzelne Markdown-Datei im Wurzelverzeichnis einer Website, die grossen Sprachmodellen (Large Language Models, LLMs) eine kuratierte, maschinenlesbare Übersicht der wichtigsten Inhalte gibt. Sie liegt unter /llms.txt — analog zu robots.txt — und besteht aus einer Kurzbeschreibung der Site plus einer strukturierten Linkliste zu den zentralen Seiten. Vorgeschlagen wurde das Format 2024 von Jeremy Howard (Answer.AI) als offener Vorschlag, nicht als offizieller W3C- oder IETF-Standard.
Der Kerngedanke: Eine typische HTML-Seite ist voller Navigation, Skripte, Tracking und Layout-Rauschen. Ein Sprachmodell muss dieses Rauschen erst herausfiltern, bevor es an die eigentlichen Fakten kommt. llms.txt liefert stattdessen von vornherein eine saubere, verdichtete Landkarte der Site — in genau dem Format (Markdown), das Sprachmodelle am zuverlässigsten verarbeiten.
Ergänzt wird llms.txt oft durch eine llms-full.txt: die Klartext-Vollversion, die den gesamten relevanten Inhalt der Website als eine einzige, zusammenhängende Markdown-Datei bereitstellt. Während llms.txt die Übersicht ist, ist llms-full.txt der komplette Kontext in einem Abruf.
Wozu dient llms.txt?
llms.txt senkt die Cost of Retrieval — den Aufwand, mit dem eine Maschine die relevanten Fakten aus einer Website herausholt — und verbessert dadurch die Zitierbarkeit einer Domain in KI-Antwortmaschinen. Je weniger eine KI arbeiten muss, um Ihre Kernfakten sauber zu extrahieren, desto eher nutzt und zitiert sie Ihre Quelle.
Konkret erfüllt die Datei drei Aufgaben. Erstens: Sie verdichtet. Statt Dutzende HTML-Seiten mit Navigation und Skripten zu parsen, findet eine KI in llms.txt eine kompakte Zusammenfassung samt priorisierter Linkliste. Zweitens: Sie priorisiert. Sie entscheiden, welche Seiten zuerst genannt werden — die Datei ist redaktionell kuratiert, keine automatisch generierte Vollliste. Drittens: Sie standardisiert das Format. Markdown ist für Sprachmodelle verlässlicher zu verarbeiten als verschachteltes HTML.
llms.txt ist damit ein Baustein von Agent-Ready Webdesign — der technischen, maschinenlesbaren Schicht einer Website. Sie ersetzt weder zitierfähigen Fliesstext im HTML noch sauberes JSON-LD, sondern arbeitet mit beiden zusammen.
Wie ist llms.txt aufgebaut?
llms.txt folgt einer schlanken Markdown-Struktur: eine H1-Überschrift mit dem Site-Namen, ein Blockzitat als Kurzbeschreibung, optional ein paar Sätze Kontext und danach thematische H2-Abschnitte mit Linklisten. Das Format ist bewusst minimal, damit sowohl Menschen als auch Maschinen es sofort erfassen.
Die Bestandteile im Überblick:
- H1 (Titel) — Pflicht
- Der Name der Website oder des Projekts, z. B. # Studio Erdinc.
- Blockzitat (Zusammenfassung) — empfohlen
- Ein kurzer, self-contained Absatz mit > davor, der in ein bis zwei Sätzen sagt, worum es geht.
- Kontextabschnitte — optional
- Freier Markdown-Text mit weiteren Details, ohne feste Überschrift.
- H2-Abschnitte mit Linklisten — Kern
- Thematisch gegliederte Listen im Format - [Ankertext](URL): kurze Beschreibung. Beschreibende Anker statt «hier klicken».
- Abschnitt «Optional» — optional
- Ein per Konvention so benannter H2, dessen Links eine KI bei knappem Kontextfenster weglassen darf.
Wichtig für die Zitierbarkeit: Jeder Link sollte einen beschreibenden Ankertext und eine kurze Erklärung tragen, damit ein Sprachmodell den Zweck der Zielseite versteht, ohne sie erst abrufen zu müssen. Ein Claim pro Zeile, die Entität benannt — dieselbe Disziplin wie bei zitierfähigem Fliesstext.
Wie sieht ein llms.txt-Beispiel aus?
Ein minimales llms.txt besteht aus Titel, Blockzitat und einem H2-Abschnitt mit beschreibend verlinkten Kernseiten. Das folgende gekürzte Beispiel zeigt die Struktur:
# Studio Erdinc — Webdesign & Semantic SEO aus dem Zürcher Oberland

> Studio Erdinc ist ein Webdesign-, Semantic-SEO- und GEO-Studio aus
> Wetzikon (Zürcher Oberland), gegründet von Özden Erdinc. Handcodierte
> Websites, Lighthouse je 100 in Accessibility, Best Practices
> und SEO, agent-ready.

## Kernseiten

- [Startseite](https://studioerdinc.ch/): Positionierung, Pakete, Methode,
  Kontakt. Markdown-Zwilling: /index.md
- [Agent-Ready Webdesign](https://studioerdinc.ch/agent-ready-webdesign.html):
  llms.txt, Markdown-Twins, JSON-LD @graph, Zero-JS-Parität.

## Optional

- [Vollständiger Klartext](https://studioerdinc.ch/llms-full.txt): gesamte
  Website als eine Markdown-Datei.
Man erkennt das Muster: Titel, verdichtete Beschreibung, kuratierte Links mit Kontext. Die echte llms.txt dieser Domain liegt unter https://studioerdinc.ch/llms.txt — sie ist selbst der Beleg für dieses Format.
Worin unterscheidet sich llms.txt von robots.txt und sitemap.xml?
robots.txt, sitemap.xml und llms.txt haben unterschiedliche Zielgruppen und Zwecke und ersetzen sich nicht — eine agent-ready Website hat idealerweise alle drei. Die Abgrenzung in einem Satz je Datei:
- robots.txt — Zugriffsregeln für Crawler
- Eine Textdatei im Root, die festlegt, welche Bots welche Pfade crawlen dürfen. Sie steuert Erlaubnis, nicht Inhalt — und muss KI-Crawler wie ClaudeBot, GPTBot oder PerplexityBot bewusst freigeben.
- sitemap.xml — vollständige URL-Liste für Suchmaschinen
- Eine XML-Datei, die alle indexierbaren URLs samt Metadaten (Änderungsdatum, Priorität) für die Suchmaschinen-Indexierung auflistet. Sie ist vollständig und maschinell erzeugt, nicht kuratiert.
- llms.txt — kuratierte Inhaltsübersicht für Sprachmodelle
- Eine Markdown-Datei, die den wichtigsten Inhalt redaktionell verdichtet und für LLMs lesbar aufbereitet. Sie ist kuratiert und priorisiert, nicht vollständig.
Kurz: robots.txt sagt «was darf gecrawlt werden», sitemap.xml sagt «was gibt es alles», llms.txt sagt «was ist wirklich wichtig — und hier in lesbarer Form». Alle drei zusammen ergeben eine niedrige Cost of Retrieval für Maschinen.
Wie setzt Studio Erdinc llms.txt ein?
Studio Erdinc gibt jeder handcodierten Website eine llms.txt und eine llms-full.txt — die eigene Domain studioerdinc.ch ist selbst der Beweis dafür. Unter /llms.txt liegt die kuratierte Übersicht mit Positionierung, Kernseiten und Angebot; unter /llms-full.txt die vollständige Klartextfassung der Website in einer Datei.
Diese Dateien sind Teil einer vollständigen Agent-Ready-Schicht: llms.txt und llms-full.txt, Markdown-Zwillinge zu den HTML-Seiten, JSON-LD @graph, eine bot-freundliche robots.txt und Zero-JavaScript-Content-Parität. Das Ziel ist eine minimale Cost of Retrieval — die Kernfakten stehen bereits im ausgelieferten HTML und zusätzlich verdichtet in Markdown, damit sowohl klassische Crawler als auch KI-Agenten sie mühelos auslesen.
Als eigenständige Leistung setzt Studio Erdinc die maschinenlesbare Schicht als Teil des Zitiert-Layers ab CHF 1'900 auf; die komplette Agent-Ready-Schicht gibt es ab CHF 2'400. Sie greift eng mit Generative Engine Optimization (GEO) ineinander: llms.txt macht die Fakten technisch auffindbar, GEO sorgt dafür, dass der Content tatsächlich zitiert wird.
llms.txt erstellen lassen — oder Generator nutzen?
Gratis-Generatoren erzeugen eine llms.txt als einmaligen Schnappschuss — gepflegt wird sie damit nicht: Neue Seiten, geänderte Preise und umbenannte Leistungen machen die Datei schleichend falsch, und eine veraltete llms.txt führt KI-Systeme aktiv in die Irre. Der Wert liegt nicht im Erzeugen, sondern im Aktuell-Halten — die Datei muss bei jeder inhaltlichen Änderung mitziehen.
Bei Studio Erdinc entsteht die llms.txt deshalb als Teil des Zitiert-Layers (ab CHF 1'900) — abgestimmt mit Markdown-Twins und JSON-LD statt als isolierter Generator-Export. Laufend nachgeführt wird sie im Website-Abo Zitiert (CHF 349/Mt.).
Häufige Fragen zu llms.txt
- Ist llms.txt ein offizieller Standard?
- llms.txt ist ein 2024 von Jeremy Howard (Answer.AI) vorgeschlagener, offener Vorschlag, aber kein von einem Standardisierungsgremium wie dem W3C oder der IETF verabschiedeter Standard. Die Datei wird von KI-Anbietern freiwillig berücksichtigt, es gibt keine Garantie, dass ein bestimmtes Modell sie liest. Sinnvoll ist sie trotzdem: Sie kostet wenig Aufwand, schadet nie und senkt die Cost of Retrieval für die Systeme, die sie auswerten.
- Was ist der Unterschied zwischen llms.txt und llms-full.txt?
- llms.txt ist die kuratierte Übersicht: eine kurze Beschreibung der Site plus eine strukturierte Linkliste zu den wichtigsten Seiten. llms-full.txt ist die Klartext-Vollversion: der gesamte relevante Inhalt der Website als eine einzige, zusammenhängende Markdown-Datei, damit eine KI ohne viele Einzelabrufe den kompletten Kontext in einem Zug laden kann. Beide ergänzen sich.
- Ersetzt llms.txt die Sitemap oder robots.txt?
- Nein. robots.txt steuert, was Crawler dürfen; sitemap.xml listet für Suchmaschinen alle URLs zur Indexierung; llms.txt kuratiert für KI-Sprachmodelle die wichtigsten Inhalte in lesbarem Markdown. Die drei Dateien haben unterschiedliche Zielgruppen und Zwecke und ersetzen sich nicht gegenseitig — eine agent-ready Website hat idealerweise alle drei.
- Wo muss llms.txt liegen?
- llms.txt gehört ins Wurzelverzeichnis der Domain, also unter https://ihre-domain.ch/llms.txt — analog zu robots.txt. Dort suchen KI-Agenten die Datei standardmässig. Eine llms-full.txt liegt am selben Ort unter /llms-full.txt.
- Bringt llms.txt automatisch mehr Zitationen in ChatGPT oder Perplexity?
- Nicht automatisch. llms.txt senkt die Cost of Retrieval und macht Ihre Kernfakten leichter auffindbar, aber sie ist nur ein Baustein. Ob eine KI Sie zitiert, hängt zusätzlich von zitierfähigem Fliesstext im HTML, sauberem JSON-LD, thematischer Autorität und Crawler-Freigaben ab. llms.txt ist notwendig, aber nicht hinreichend.
Quellen
Belegstellen dieses Beitrags mit Organisation, Jahr und Link; eigene Erhebungen mit Methode und Datum. Geprüft am 6. September 2026.
- llmstxt.org: The /llms.txt file — Vorschlag, 2024. llmstxt.org
- Answer.AI (Jeremy Howard): The /llms.txt file, 2024. answer.ai
- IETF: RFC 9309: Robots Exclusion Protocol, 2022. rfc-editor.org
- OpenAI: Overview of OpenAI crawlers (GPTBot, OAI-SearchBot, ChatGPT-User), 2026. developers.openai.com
- Anthropic: Does Anthropic crawl data from the web? (ClaudeBot, Claude-User), 2026. support.claude.com
- Perplexity: Perplexity crawlers (PerplexityBot, Perplexity-User), 2026. docs.perplexity.ai
Website, die KI zuverlässig liest?
Wir bauen Ihre Website handcodiert mit vollständiger Agent-Ready-Schicht — llms.txt inklusive.
Kostenloses Erstgespräch